#==============================================================================#
# IESP/UERJ, 2025.I
# LEGO 3 - LISTA 01
# Nome: Felipe Marques Esteves Lamarca
# Email: felipelamarca@iesp.uerj.br
# Data: 11/05/2026
#==============================================================================#
# +++ INSTRUCOES +++ ===========================================================
# 1. Preencha seu nome, email e data no cabecalho acima
# 2. Edite a secao ``pasta de trabalho`` para indicar a pasta no seu computador
# onde estao os arquivos necessarios para a lista (este script e os dois arquivos
# em csv)
# 3. Edite a secao ``pacotes`` para instalar (se necessario) e carregar os scripts
# necessarios para a execucao de TODA a lista
# 4. Acrescente sua resposta aos itens
# 5. Salve o script com o nome ``SEUNOME-lego3-lista01.r`` e envie para:
# - pedrosouza@iesp.uerj.br
# - rogerio.barbosa@iesp.uerj.br
# - carloscr@iesp.uerj.br
# Somente serao aceitas respostas que usem este script como modelo.
# +++ PASTA DE TRABALHO +++ ====================================================
# Altere o objeto ``pasta_local`` para indicar a pasta contendo os arquivos csv e
# este script. Use barras, e nao contra-barras (por ex: 'c:/iesp/lego3/')
# Pasta local
pasta_local <- here::here('trabalhos/lista-01')
# Comando para o R usar como referencia a pasta local
setwd(pasta_local)
# +++ PACOTES +++ ==============================================================
# Inclua nesta secao os comandos para carregar todos os pacotes desejados.
# Por ex: library(tidyverse); library(feols) etc.
library(tidyverse)
library(fixest)
library(MatchIt)
options(scipen = 999)
# +++ 4. VARIAVEIS ALEATORIAS CONTINUAS +++ ====================================
# 4.1. Valor esperado de variavel uniforme -------------------------------------
n = 10000
u = runif(n, min = 4, max=10)
mean(u)
# 4.2. Probabilidade acumulada de variavel uniforme ----------------------------
punif(6, min=4, max=10)
# 4.3. Probabilidade acumulada de variavel normal ------------------------------
1-pnorm(38, mean=34, sd=2)
# 4.4. Probabilidade acumulada de variavel logistica padrao --------------------
1 - (1 / (1 + exp(-3)))
# ou ainda...
1 - plogis(3)
# 4.5. Funcao logit ------------------------------------------------------------
qlogis(0.99)
# ou ainda...
log(0.99 / (1-0.99))
# +++ 6. CASOS EXTRACONJUGAIS +++ ==============================================
affairs = read.csv("affairs.csv")
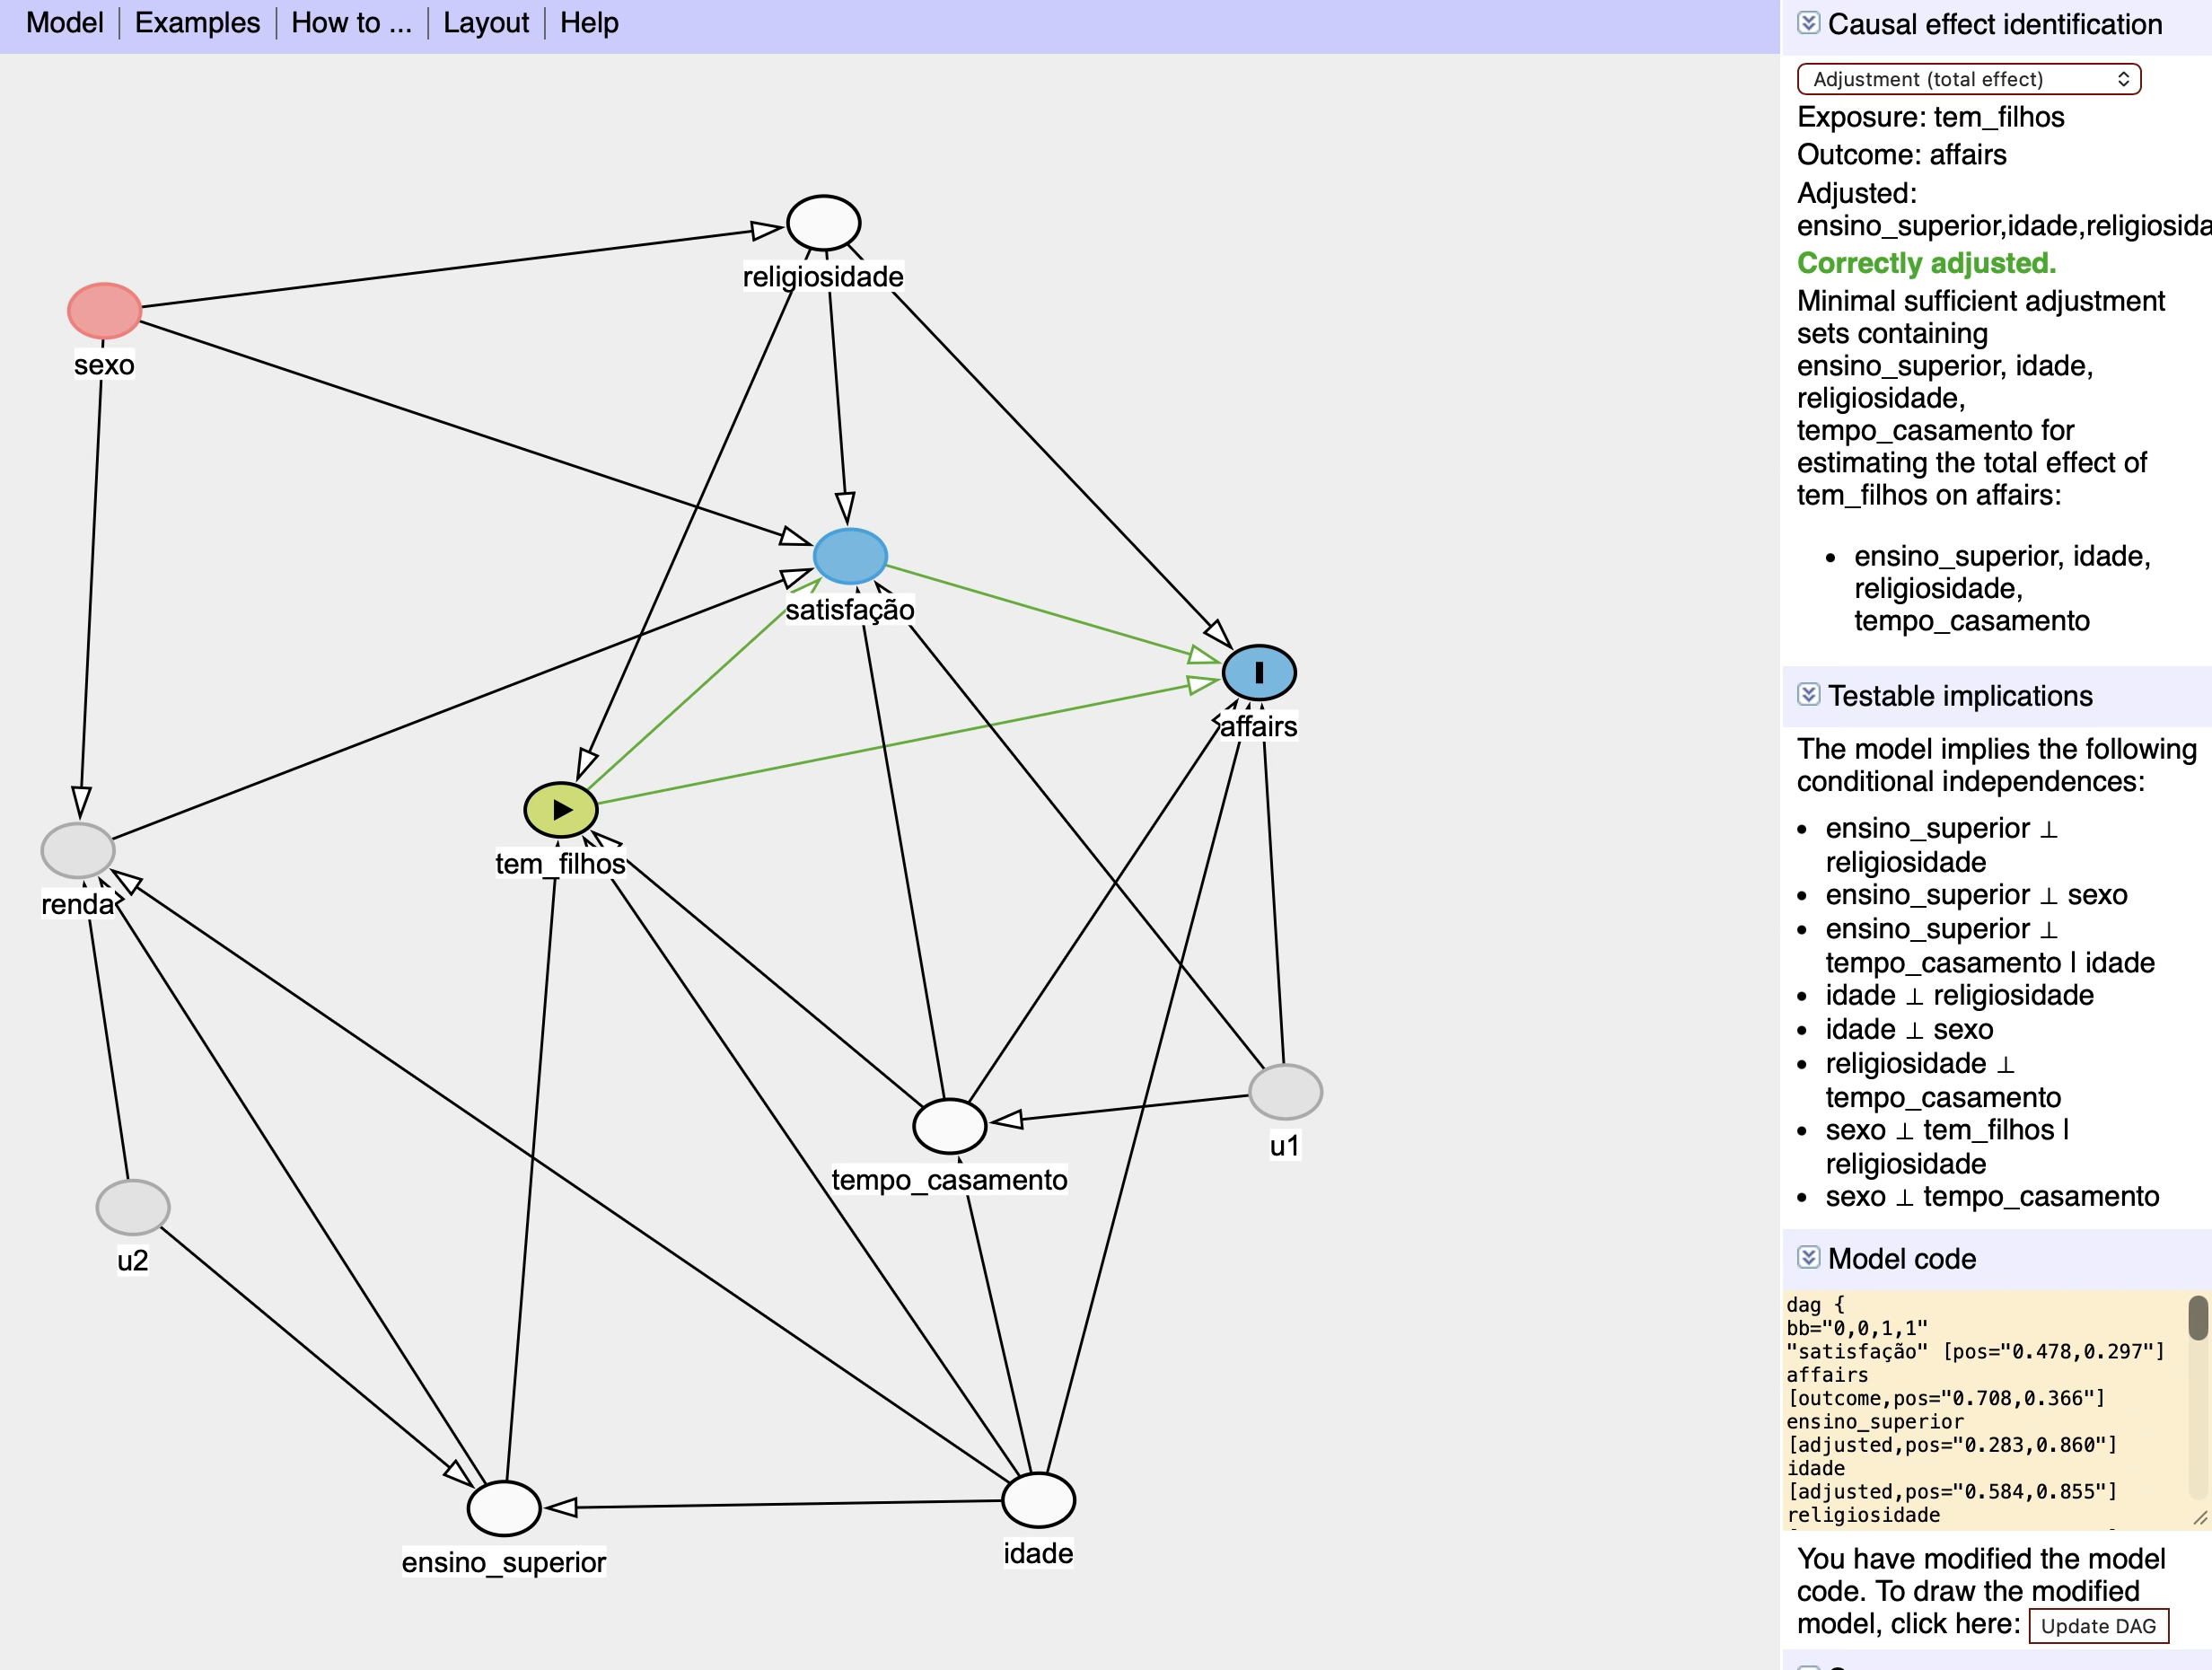
# 6.2. Implicacoes testaveis do DAG --------------------------------------------
cor(affairs$homem, affairs$tempo_casamento)
# 6.3. Estimando o modelo de probabilidade linear ------------------------------
affairs <- affairs %>%
mutate(
tem_filhos = factor(tem_filhos),
ensino_superior = factor(ensino_superior)
)
m1 <- feols(
fml = affair ~ ensino_superior + idade + religiosidade + tempo_casamento + tem_filhos,
data = affairs,
vcov = "HC1"
)
summary(m1)
# 6.5. Calculo de valores preditos no LPM --------------------------------------
novo <- data.frame(
ensino_superior = factor(0, levels = c("0", "1")),
idade = 50,
religiosidade = 5,
tempo_casamento = 1,
tem_filhos = factor(0, levels = c("0", "1"))
)
# Probabilidade predita
predict(m1, newdata = novo)
# 6.6. Estimando o modelo logit ------------------------------------------------
m2 <- glm(
formula = affair ~ ensino_superior + idade + religiosidade + tempo_casamento + tem_filhos,
data = affairs,
family = binomial(link = "logit")
)
summary(m2)
# 6.8. Calculo de valores preditos no logit ------------------------------------
# Probabilidade predita
plogis(predict(m2, newdata = novo))
# +++ 7. SELECAO EM OBSERVAVEIS +++ ============================================
lalonde_experimento = read.csv("lalonde_experimento.csv")
lalonde_cps = read.csv("lalonde_cps.csv")
# 7.1. Analise descritiva ------------------------------------------------------
lalonde_experimento %>%
group_by(treat) %>%
summarise(
mean_age = mean(age),
mean_education = mean(education),
mean_black = mean(black),
mean_re74 = mean(re74),
mean_re75 = mean(re75)
)
lalonde_cps %>%
group_by(treat) %>%
summarise(
mean_age = mean(age),
mean_education = mean(education),
mean_black = mean(black),
mean_re74 = mean(re74),
mean_re75 = mean(re75)
)
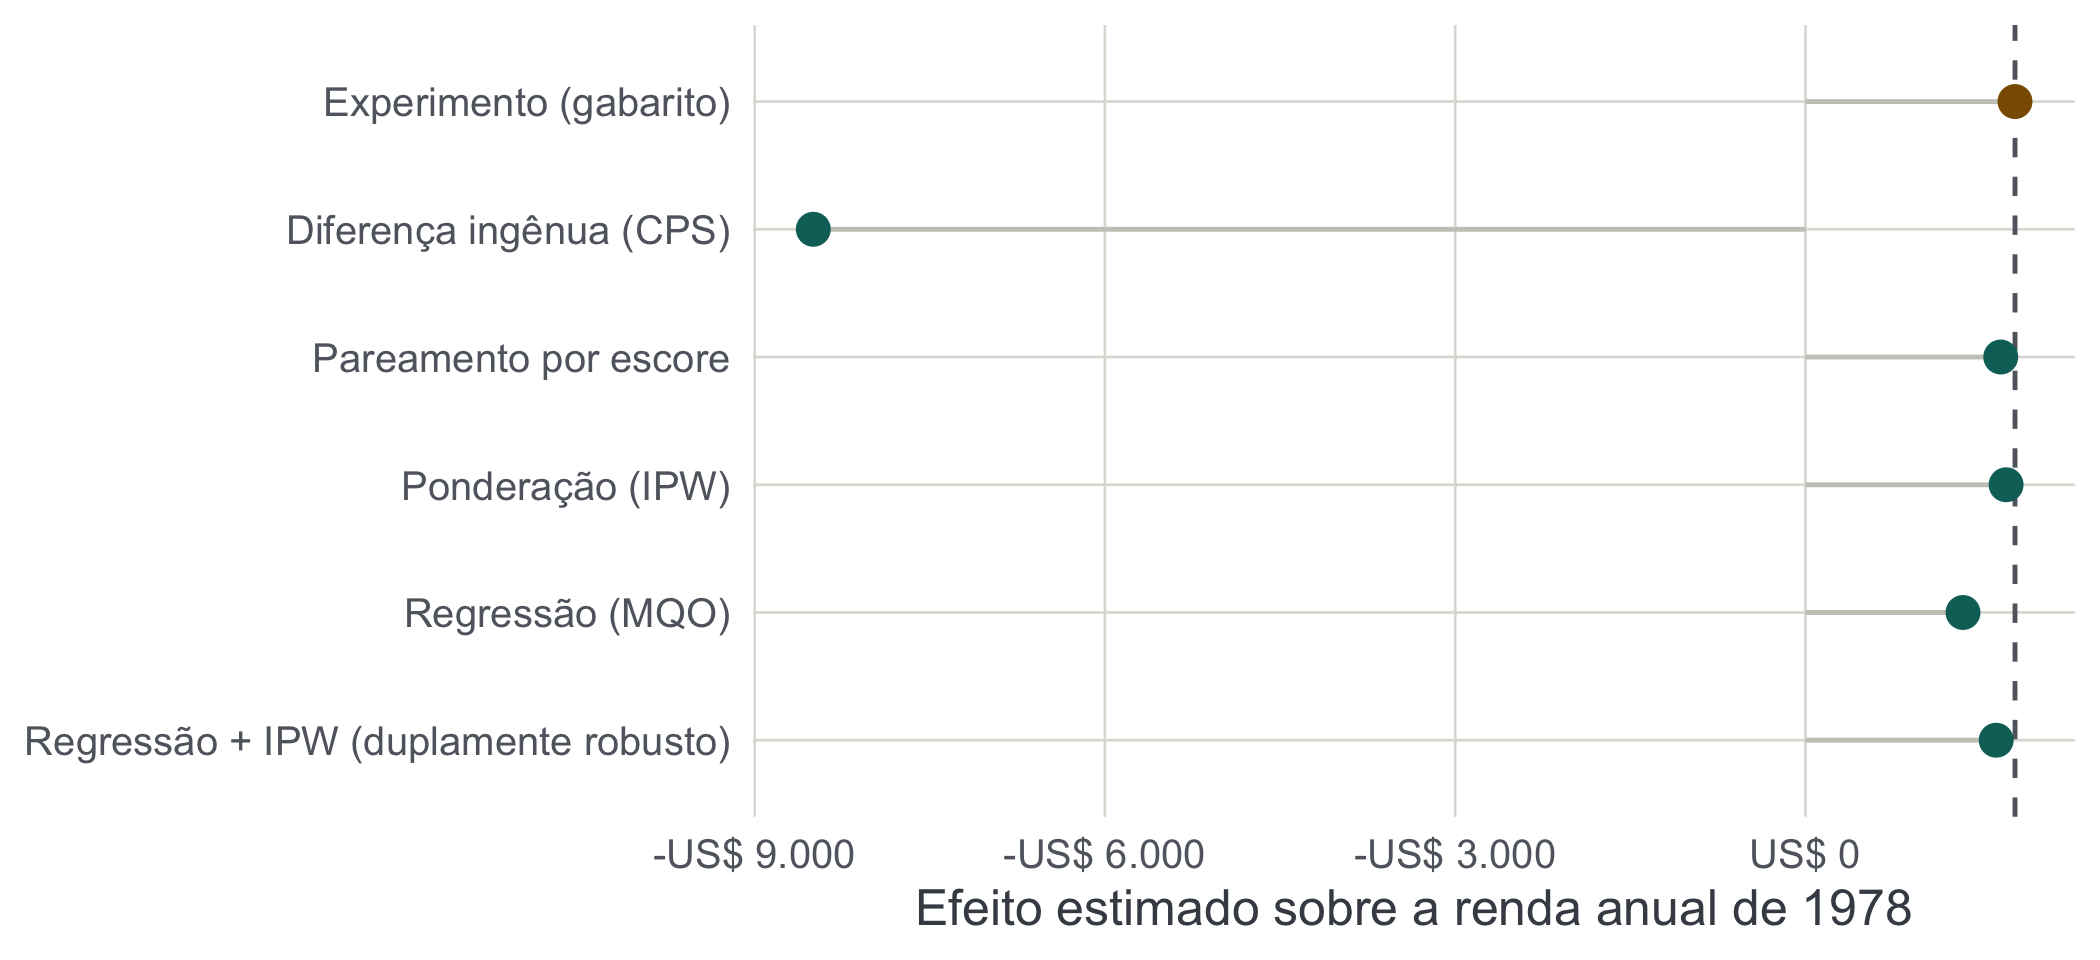
# 7.2. ATT no experimento ------------------------------------------------------
att_tbl_experimento = lalonde_experimento %>%
group_by(treat) %>%
summarise(mean_re78 = mean(re78))
att_experimento = att_tbl_experimento$mean_re78[att_tbl_experimento$treat == 1] -
att_tbl_experimento$mean_re78[att_tbl_experimento$treat == 0]
print(att_experimento)
# 7.3. ATT ingenuo nos dados nao experimentais ---------------------------------
att_tbl_cps = lalonde_cps %>%
group_by(treat) %>%
summarise(mean_re78 = mean(re78))
att_cps = att_tbl_cps$mean_re78[att_tbl_cps$treat == 1] -
att_tbl_cps$mean_re78[att_tbl_cps$treat == 0]
print(att_cps)
# 7.4. Estimacao do propensity score -------------------------------------------
m3_ps = glm(
formula = treat ~ age + agesq + agecube +
education + educationsq +
black + hispanic +
married +
re74 + re74sq + re75 + re75sq +
u74 + u75,
data = lalonde_cps,
family = binomial(link = "logit")
)
summary(m3_ps)
lalonde_cps = lalonde_cps %>%
mutate(
ps = m3_ps$fitted.values
)
lalonde_cps %>%
group_by(treat) %>%
summarise(
mean_ps = mean(ps)
)
# 7.5. Propensity score matching com vizinho mais proximo ----------------------
# Propensity score matching com o matchit
M <-
matchit(formula = treat ~ age + agesq + agecube +
education + educationsq +
black + hispanic +
married +
re74 + re74sq + re75 + re75sq +
u74 + u75, # formula que usamos para o logit
data = lalonde_cps, # data frame com os dados (edite caso necessario)
distance = lalonde_cps$ps, # propensity scores estimados (idem)
estimand = 'ATT', # estimando vai ser o ATT
method = 'nearest', # pareamento por proximidade
ratio = 1, # com apenas 1 vizinho
discard = 'treated', # restricao de suporte comum
replace = FALSE) # sem reposicao
# Equilibrio das covariadas antes e depois do pareamento
summary(M)
# data frame so com casos pareados
M_df <- match_data(M)
# Calculo do ATT para re78
lm(re78 ~ treat, data = M_df)
# 7.6. Inverse probability weighting -------------------------------------------
lalonde_cps = lalonde_cps %>%
mutate(
ipw = if_else(treat == 1, 1, ps / (1 - ps))
)
lm(re78 ~ treat, data = lalonde_cps, weights = ipw)
# 7.7. Regressao ---------------------------------------------------------------
m4_ols <- lm(re78 ~ treat +
age + agesq + agecube +
education + educationsq +
black + hispanic + married +
re74 + re74sq + re75 + re75sq +
u74 + u75,
data = lalonde_cps)
m5_wls <- lm(re78 ~ treat +
age + agesq + agecube +
education + educationsq +
black + hispanic + married +
re74 + re74sq + re75 + re75sq +
u74 + u75,
data = lalonde_cps,
weights = ipw)
summary(m4_ols)
summary(m5_wls)