Há contextos em que, mesmo fazendo experimentos, temos problemas como spillover. Nesse caso, podemos usar variáveis instrumentais de forma auxiliar. A variável instrumental por si só caiu em desuso, mas não caiu em desuso a inclusão das VI para melhorar a estimação dos efeitos causais de forma auxiliar.
Recapitulando o estimador IV e seus pressupostos:
\[
\hat{\beta}_{IV} = (Z^\top X)^{-1} Z^\top y
\]
IV1
Linearidade
IV2
i.i.d.
IV3
\(Z^\top X\) é quadrada e inversível
IV4
\(X^\top\varepsilon \neq 0\): modelo é endógeno
IV5
\(Z^\top\varepsilon = 0\): instrumento é exógeno; restrição de exclusão
IV6
\(Z^\top X \neq 0\): relevância
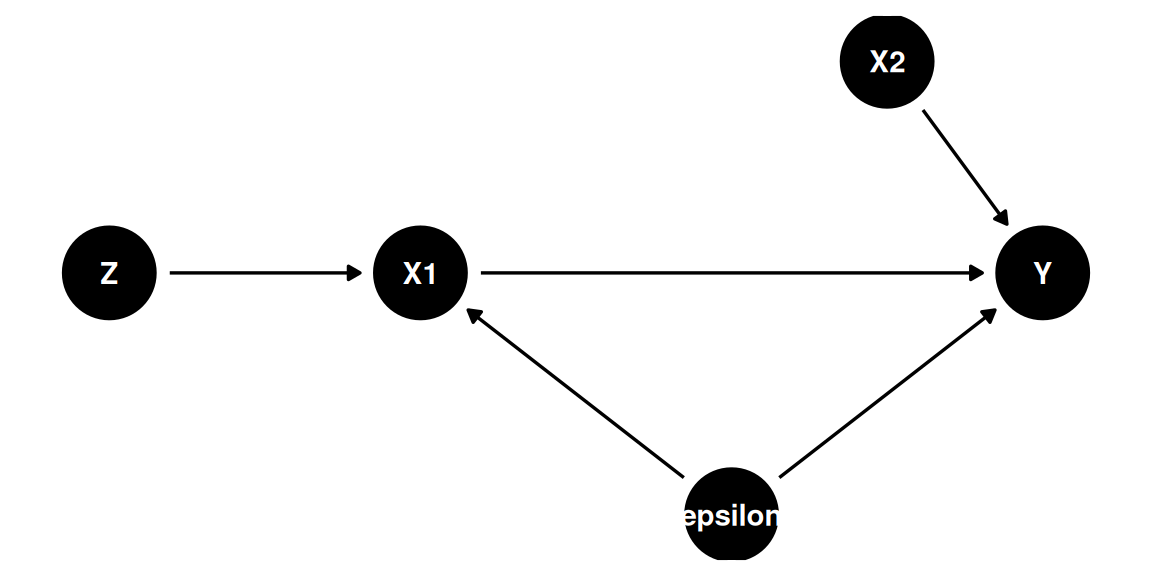
Considere um modelo com múltiplas variáveis onde apenas \(X_1\) é endógena e \(X_2\) é exógena, com instrumento \(Z\) para \(X_1\):
Código
dag_multi <-dagify( X1 ~ Z + epsilon, Y ~ X1 + X2 + epsilon,latent ="epsilon",coords =list(x =c(Z =0, X1 =1, X2 =2.5, Y =3, epsilon =2),y =c(Z =0, X1 =0, X2 =0.7, Y =0, epsilon =-0.8) ))ggdag(dag_multi) +theme_dag()
O PGD de \(Y\) é \(\beta_0 + \beta_1 X_1 + \beta_2 X_2 + \varepsilon\), mas a regressão OLS não produz o \(\beta_1\) correto porque o modelo é endógeno (\(X_1 \leftarrow \varepsilon\)). Podemos resolver isso por VI.
IV3 revisitado: regimes de identificação
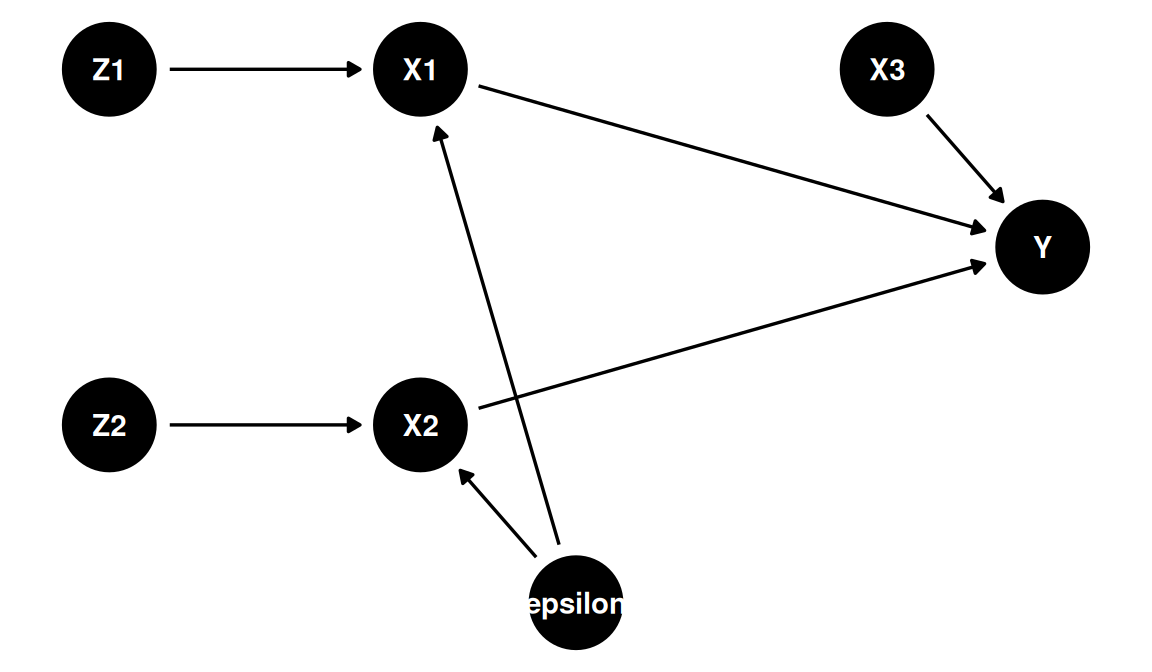
Seja \(L\) o número de colunas de \(Z\) (instrumentos + variáveis exógenas) e \(K\) o número de colunas de \(X\) (variáveis que afetam \(Y\)). Como \(Z_{n \times L}\) e \(X_{n \times K}\), o produto \(Z^\top X\) tem dimensão \(L \times K\). A matriz só admite inversa quando \(L = K\).
Isso não é apenas um requisito matemático, mas um requisito substantivo de inferência causal.
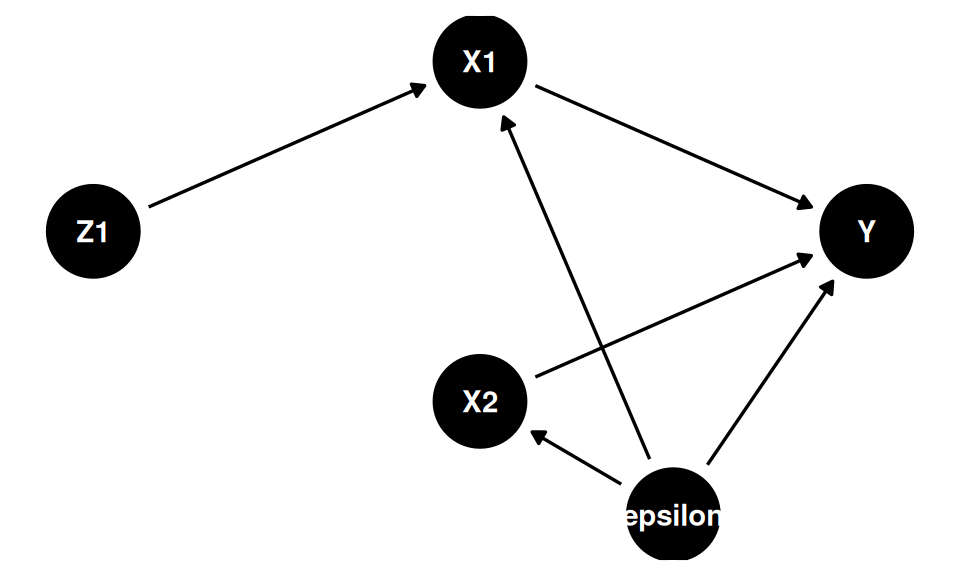
Sub-identificação (\(L < K\))
Menos instrumentos do que variáveis endógenas: não é possível inverter \(Z^\top X\). Exemplo: \(X_1\) e \(X_2\) ambas endógenas, mas há apenas um instrumento \(Z_1\).
onde \(Z\) contém o intercepto, os instrumentos e as variáveis exógenas; \(X\) contém o intercepto, as variáveis endógenas e as variáveis exógenas.
Sobre-identificação (\(L > K\))
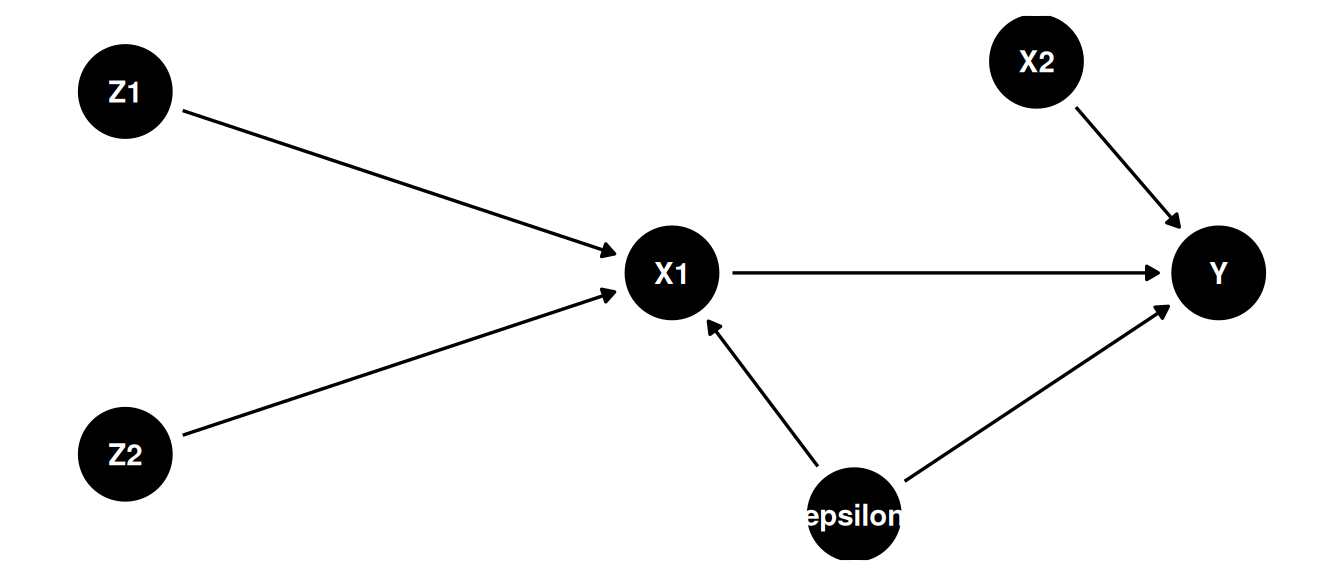
Mais instrumentos do que variáveis endógenas. Do ponto de vista informacional isso é melhor, mas as matemáticas não permitem usar o estimador IV diretamente (\(Z^\top X\) não é quadrada). Precisamos do 2SLS.
Exemplo: em Acemoglu et al. (2001), mortalidade de colonos (\(Z_1\)) e relevo (\(Z_2\)) são usados como instrumentos para a qualidade das instituições (\(X_1\)), que afeta o crescimento econômico (\(Y\)).
O estimador 2SLS pode ser visto como uma OLS ponderada, onde \(Z(Z^\top Z)^{-1}Z^\top\) é a matriz de pesos que dá peso zero à parte endógena de \(X\) e peso maior à parte exógena.
Ao usar a fórmula fechada (ao invés de dois estágios manuais), evitamos a subestimação dos erros-padrão que ocorreria porque o segundo estágio manual usaria \(\hat{X}\), não \(X\), para calcular os resíduos.
Demonstração em R
Código
set.seed(42)n <-10000e <-rnorm(n, sd =1)dados <-tibble(z1 =rnorm(n, mean =2, sd =2),x =rnorm(n, mean =10+2* z1 -5* e, sd =1),y =rnorm(n, mean =3-4* x +5* e, sd =1))# β verdadeiro de x é -4# Estratégia 1: razão de covariâncias (apenas uma var. endógena + um instrumento)beta_cov <-with(dados, cov(z1, y) /cov(z1, x))# Estratégia 2: estimador IV matricial — (Z'X)^{-1} Z'y (justa-identificação)Z <-cbind(1, dados$z1)X <-cbind(1, dados$x)y <- dados$ybeta_iv <-solve(t(Z) %*% X) %*%t(Z) %*% y# Estratégia 3: estimador 2SLS — fórmula fechada (generaliza para sobre-identificação)beta_2sls <-solve(t(X) %*% Z %*%solve(t(Z) %*% Z) %*%t(Z) %*% X) %*% (t(X) %*% Z %*%solve(t(Z) %*% Z) %*%t(Z) %*% y)# No caso de justa-identificação, todas as fórmulas convergemcat("Razão de covariâncias: ", round(beta_cov, 4), "\n")
Para uso em produção, o pacote ivreg implementa o 2SLS com erros-padrão corretos. A sintaxe y ~ x | z significa: regredir \(y\) em \(x\), usando \(z\) como instrumento. Variáveis exógenas que não são instrumentadas aparecem dos dois lados do |.
Código
modelo_ols <-lm(y ~ x, data = dados)modelo_iv <-ivreg(y ~ x | z1, data = dados)summary(modelo_ols)
Call:
lm(formula = y ~ x, data = dados)

Residuals:
     Min       1Q   Median       3Q      Max
-13.2352  -2.2528  -0.0142   2.2504  12.7325

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept) 11.278111   0.079432   142.0   <2e-16 ***
x           -4.592601   0.005118  -897.3   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.354 on 9998 degrees of freedom
Multiple R-squared:  0.9877,    Adjusted R-squared:  0.9877
F-statistic: 8.052e+05 on 1 and 9998 DF,  p-value: < 2.2e-16
Código
summary(modelo_iv)
Call:
ivreg(formula = y ~ x | z1, data = dados)

Residuals:
       Min         1Q     Median         3Q        Max
-21.467773  -3.396426   0.009404   3.415344  21.175749

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  3.06075    0.18282   16.74   <2e-16 ***
x           -4.00848    0.01248 -321.15   <2e-16 ***

Diagnostic tests:
                  df1  df2 statistic p-value
Weak instruments    1 9998      6318  <2e-16 ***
Wu-Hausman          1 9997     46540  <2e-16 ***
Sargan              0   NA        NA      NA
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 5.09 on 9998 degrees of freedom
Multiple R-Squared: 0.9718, Adjusted R-squared: 0.9718
Wald test: 1.031e+05 on 1 and 9998 DF,  p-value: < 2.2e-16
O OLS, que ignora a endogeneidade, produz um coeficiente viesado. O estimador IV recupera o valor verdadeiro \(\beta_1 = -4\).
LATE: Local Average Treatment Effect
Variáveis instrumentais renderam vários Prêmios Nobel. Uma das contribuições mais belas é a de Angrist: a formalização do LATE (Local Average Treatment Effect).
Existem quatro tipos de pessoas no mundo:
Tipo
Descrição
Always takers
Contrafactuais “fixos”: sempre fazem a mesma coisa em qualquer situação
Never takers
Idem: nunca mudariam de comportamento independentemente do instrumento
Compliers
Pessoas cujas vidas são efetivamente mudadas pela variável instrumental
Defiers
Fazem o oposto do instrumento (o pressuposto IV7 é exatamente “no defiers”)
O problema é que a VI estima o efeito causal apenas para os compliers. A variável instrumental não captura o efeito causal no abstrato: há pessoas que têm versões idênticas em qualquer contrafactual e que, portanto, não sofrem o efeito causal.
Nota
Essa discussão é um dos usos mais interessantes da notação de inferência causal, pois torna explícita a heterogeneidade de efeitos que a VI é capaz de identificar.
Problema adicional: a distribuição da população em cada um desses grupos depende do instrumento utilizado. Isso limita o Teste de Sargan, um teste de sobre-identificação que avalia a validade conjunta dos instrumentos.
Acemoglu, Daron, Simon Johnson, e James A. Robinson. 2001. “The Colonial Origins of Comparative Development: An Empirical Investigation”. American Economic Review 91 (5): 1369–401. https://doi.org/10.1257/aer.91.5.1369.